Perché il gioco più stupido del mondo spiega quasi tutto quello che conta sui mercati
Osservatorio FINBEAR · Fondamenti quantitativi
Pubblicato per la prima volta nel settembre 2021. Riscritto integralmente il 27 luglio 2026.
Nota di apertura
Stiamo preparando QUANT, l’area che consegnerà un insieme di titoli selezionati in modo sistematico.
Questo articolo serve a leggerla, quella lista. Perché la si può ricevere in due modi: come promessa — e allora prima o poi delude — oppure sapendo che cos’è un vantaggio statistico, quanto piccolo può essere restando vero, e perché nessuno può dirti come cadrà il prossimo lancio.
Si comincia da una moneta.
Una moneta ha due facce. Non c’è modello più povero di così, e proprio per questo è il posto giusto da cui partire: quando un oggetto ha una sola regola, tutto quello che ne esce non può che venire dalla regola.
Da questa povertà nascono la deviazione standard, la deriva, il moto browniano, la formula di Black-Scholes e — con un passaggio in più — la ragione per cui un portafoglio può avere ragione in media e morire lo stesso.
La moneta non ti dirà dove va il mercato domani. Ti dirà una cosa più scomoda: che la domanda “dove va domani” è mal posta.
Due facce, e ci siamo già persi
Un lancio. Due esiti:
\[S_1=\{T,C\}\]
Se la moneta è equilibrata, ognuno vale 0,5. Un singolo lancio è una prova di Bernoulli; contare quante Teste escono su N lanci ci porta nella distribuzione binomiale.
Due lanci danno quattro sequenze. Tre ne danno otto. Dodici ne danno 4.096. Cento lanci ne danno:
\[2^{100} \approx 1{,}27 \times 10^{30}\]
Un numero che supera di circa tremila miliardi di volte il numero di secondi trascorsi dal Big Bang.
Una regola sola. Nessuna intenzione, nessun attore, nessuna strategia. E lo spazio dei percorsi possibili esplode al punto che nessun calcolatore potrà mai enumerarli.
Tienilo da parte, perché è la prima lezione operativa del pezzo: la complessità che vedi su un grafico non è una prova che dietro ci sia qualcuno che la produce. Poche regole bastano.
Costruiamo la passeggiata
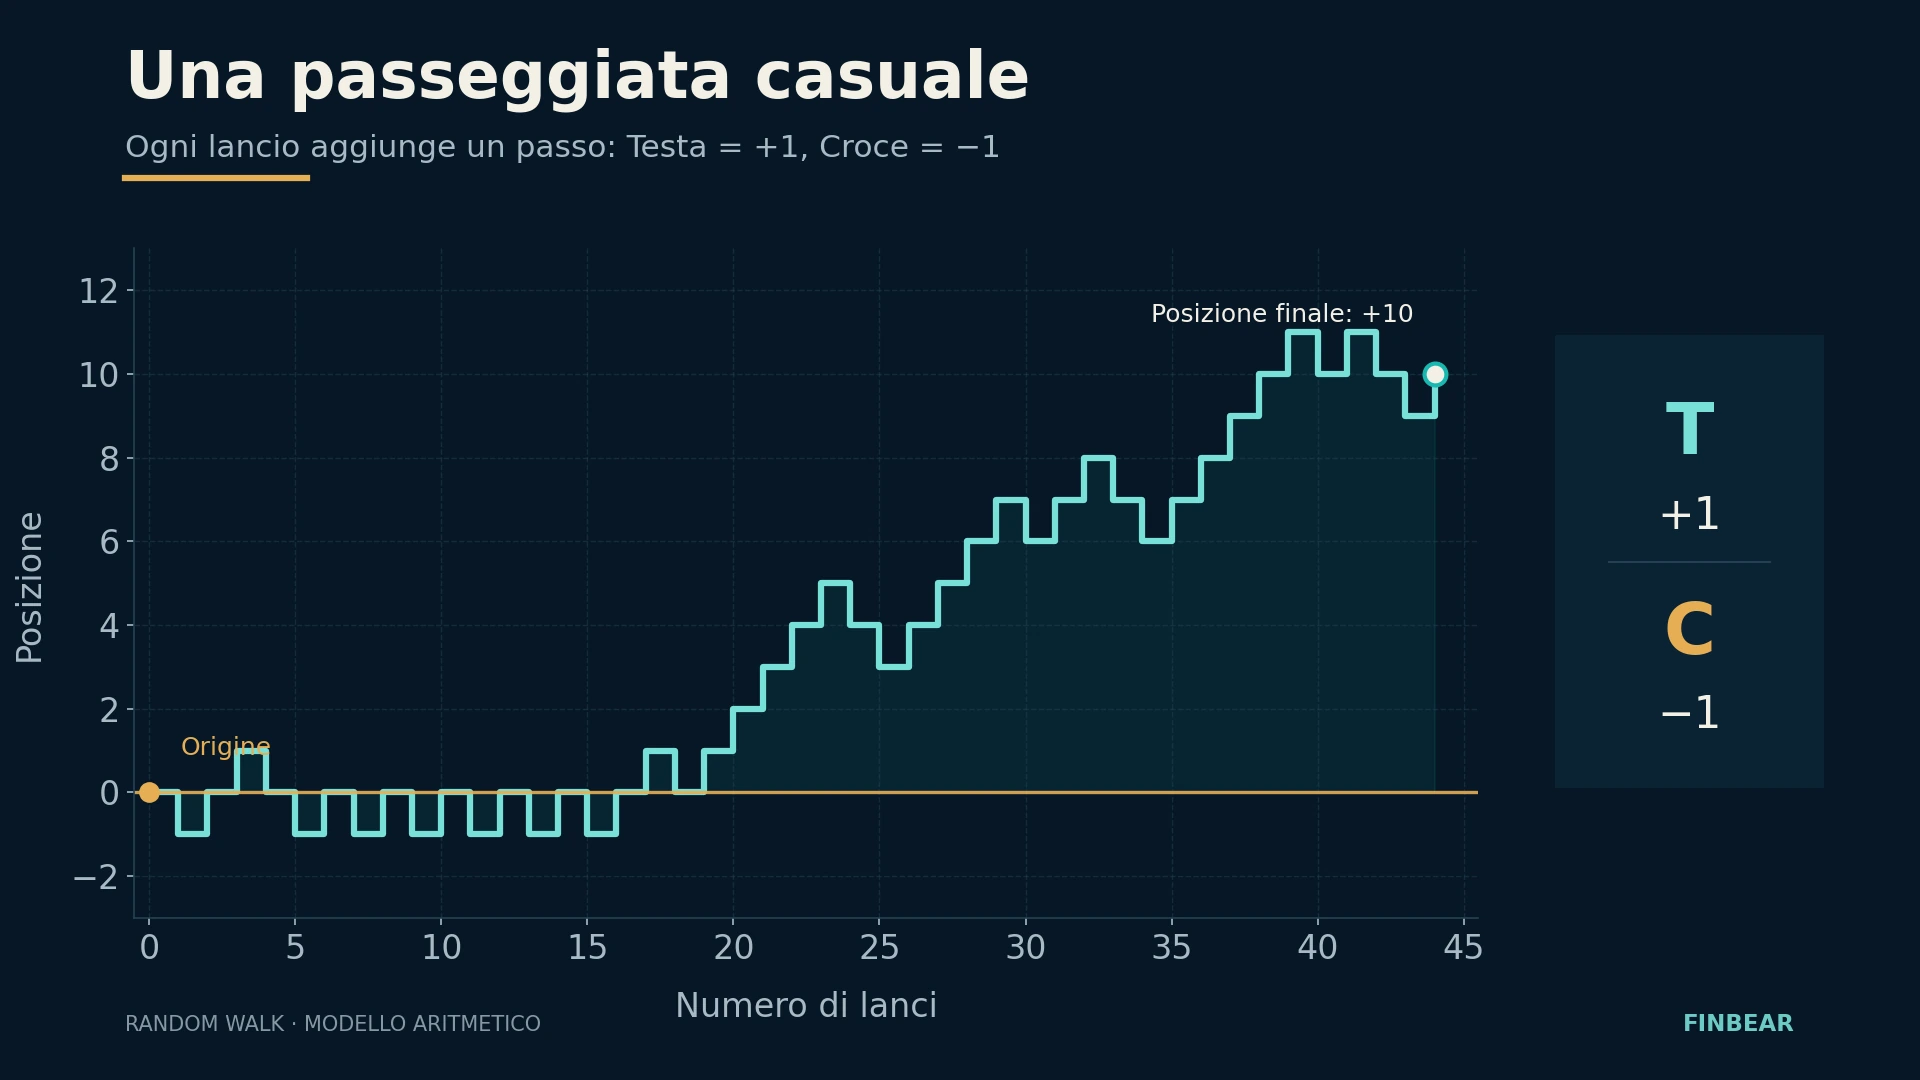
Assegniamo un numero ai due esiti — Testa vale +1, Croce vale −1 — partiamo da zero e lanciamo N volte. La posizione dopo N lanci è la somma dei passi:
\[D_N = X_1 + X_2 + \dots + X_N\]
Ogni \(X_i\) vale solo +1 o −1. Il percorso sale, scende, torna sopra, sfonda sotto. Disegna una linea spezzata che, senza aver mai deciso niente, somiglia moltissimo a un grafico di prezzo.
Si chiama passeggiata casuale — random walk.
Il valore atteso non è una previsione
Per una moneta equilibrata il valore atteso di un passo è zero:
\[E(X) = (-1 \times 0{,}5) + (+1 \times 0{,}5) = 0\]
E quindi \(E(D_N) = 0\).
Qui casca il novanta per cento di chi legge la formula per la prima volta, e casca male. Valore atteso zero non significa che finirai a zero. Significa che la distribuzione di tutti i finali possibili è centrata sullo zero. Nessuno dei percorsi è obbligato a passare di lì.
Perché mentre il centro sta fermo, la larghezza cresce. Nel caso della moneta equilibrata:
\[Var(D_N) = N \qquad \sigma(D_N) = \sqrt{N}\]
Dopo 100 lanci la deviazione standard della posizione finale è 10 passi. Dopo 10.000 lanci è 100 passi. Il centro non si è mosso di un millimetro; l’incertezza si è decuplicata.
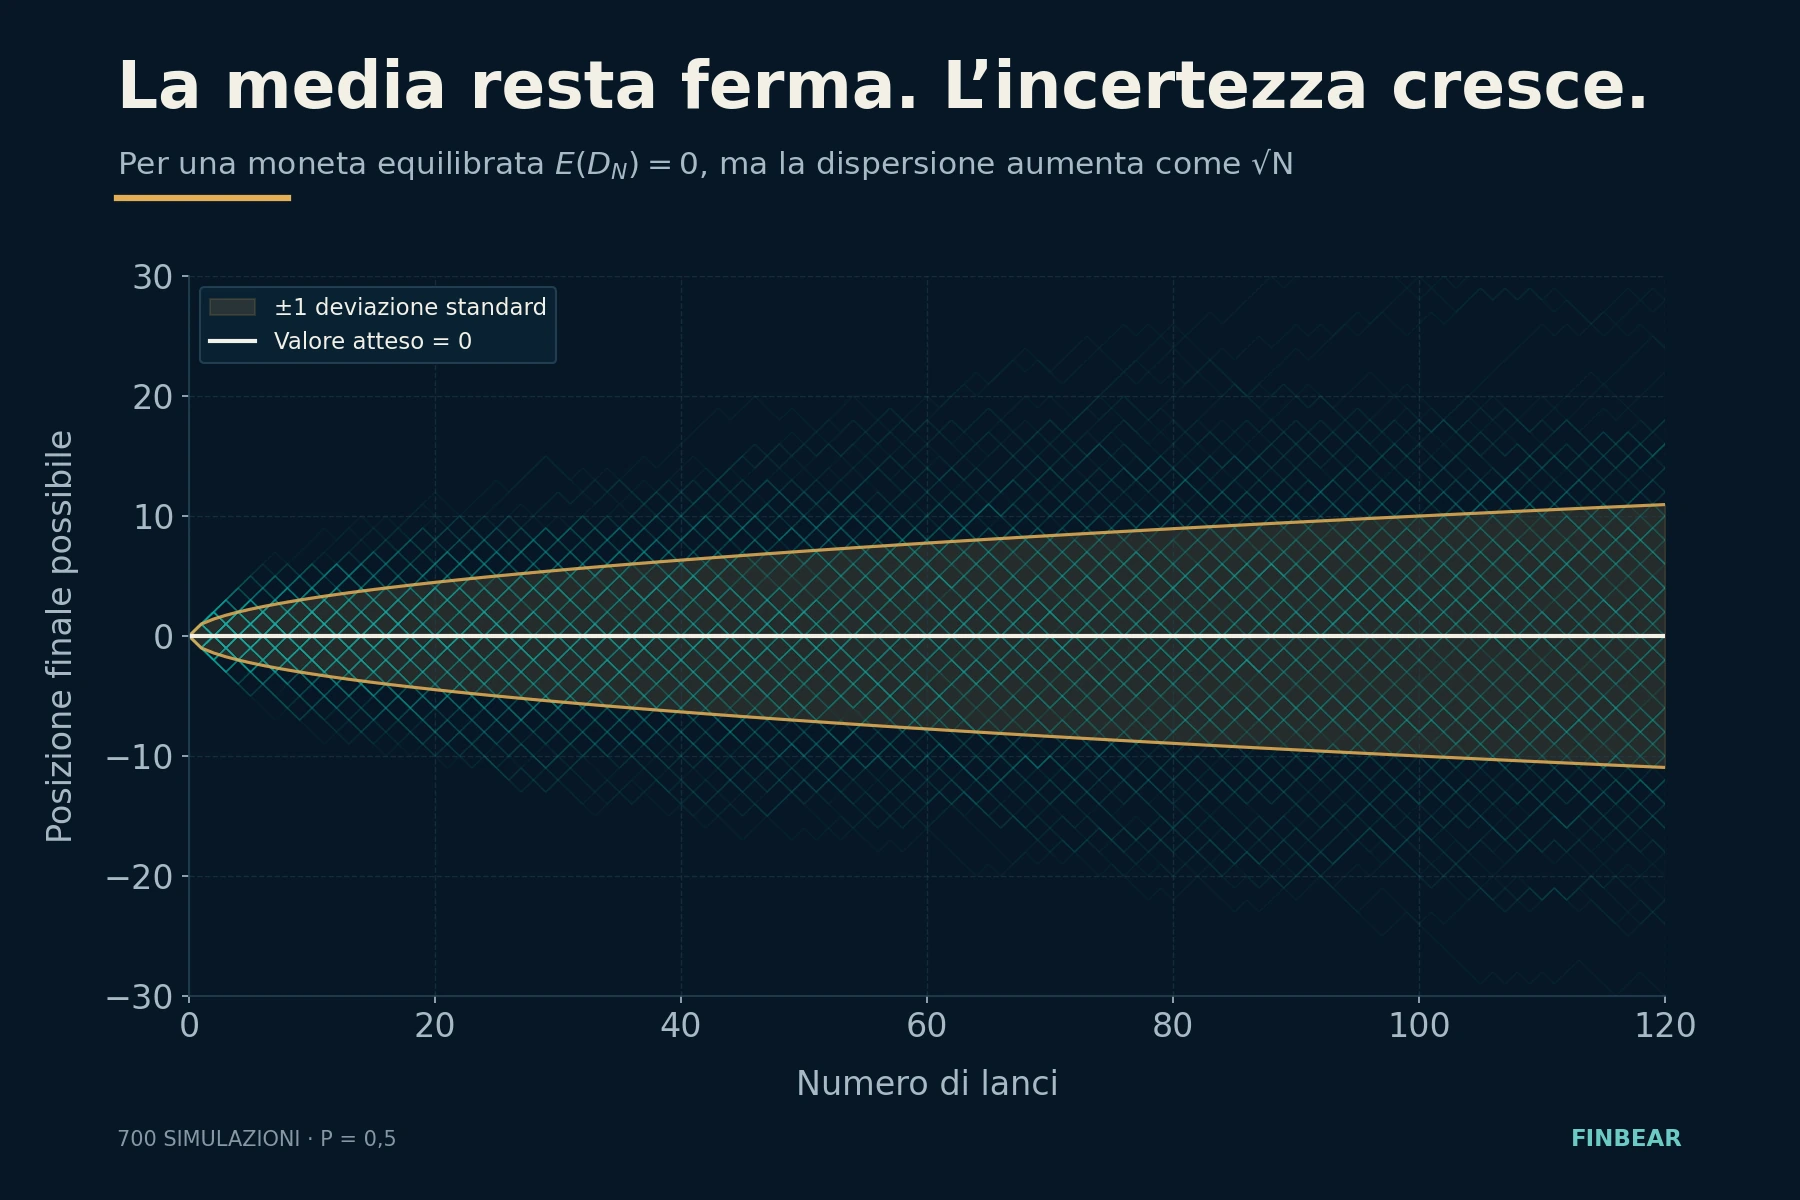
È la radice quadrata del tempo, e la incontrerai ovunque: nell’annualizzazione della volatilità, nell’ampiezza delle bande, in qualunque stima di rischio su orizzonte. Un giorno di volatilità all’1% non fa 252% all’anno — fa circa 16%, perché \(\sqrt{252} \approx 15{,}9\).
E qui la lezione smette di essere matematica e diventa mestiere.
Un metodo con valore atteso positivo può attraversare mesi di risultati negativi senza che nulla si sia rotto. Un metodo senza alcun vantaggio può produrre sei mesi eccellenti per puro caso — e convincere il suo autore di essere un genio.
Non basta avere ragione. Bisogna sopravvivere alla dispersione dei risultati.
Chi ti vende una strategia mostrandoti solo la media ti ha mostrato metà del problema. E ti ha mostrato la metà rassicurante.
E se la moneta è truccata?
Mettiamo che Testa valga \(p\) e Croce \(1-p\). Il passo atteso diventa:
\[E(X) = p – (1-p) = 2p – 1\]
\[E(D_N) = N(2p-1)\]
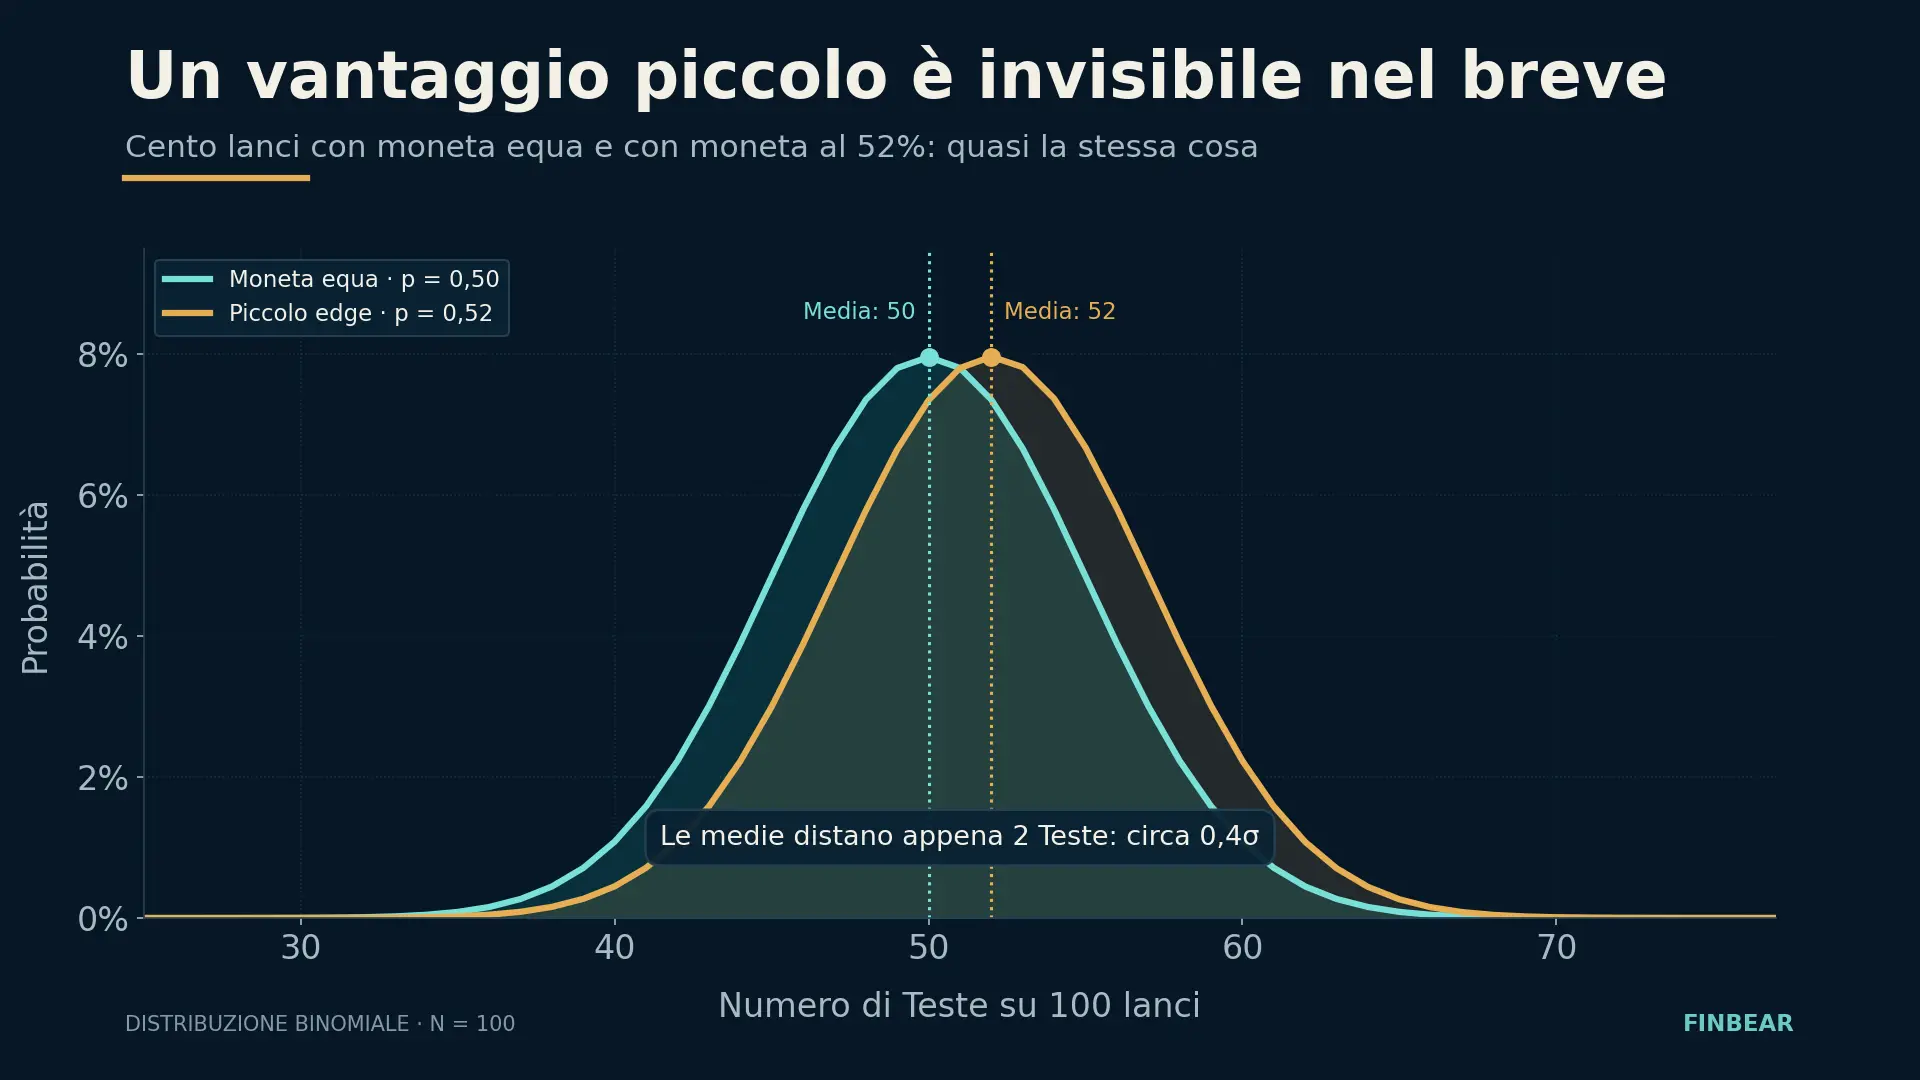
Se \(p > 0{,}5\) la passeggiata ha una deriva positiva. Se \(p < 0{,}5\), negativa. Se \(p = 0{,}5\), nessuna direzione privilegiata.
Quello scarto dal 50% è la forma più elementare di vantaggio statistico — l’edge. Ed è tutto quello che serve: non la certezza, non la ragione ogni volta. Uno scarto piccolo e persistente.
Ma attenzione a non confondere l’edge con il profitto, perché sono due cose diverse e la differenza uccide portafogli. Un metodo che vince nel 40% dei casi può essere ottimo se quando ha ragione guadagna il triplo di quanto perde quando ha torto. Un metodo che vince nel 70% può essere disastroso se le tre perdite su dieci sono enormi. Il vantaggio non abita nella frequenza delle vittorie: abita nel prodotto tra probabilità e dimensione degli esiti, al netto dei costi.
E c’è un terzo termine che quasi nessuno mette in conto, ed è la conseguenza diretta del \(\sqrt{N}\) di due paragrafi fa: quanto scommetti. Un vantaggio reale, giocato troppo grosso, produce rovina con probabilità uno. È il problema che John Kelly formalizzò nel 1956 lavorando sul rumore nelle linee telefoniche, e che i mercati hanno riscoperto una crisi dopo l’altra.
Avere ragione, sapere quanto vale avere ragione, e restare al tavolo. Tre cose, non una.
Dal passo alla percentuale
La passeggiata costruita finora è aritmetica: ogni passo aggiunge o toglie una quantità fissa. Ma un euro non significa la stessa cosa su un titolo da 10 euro e su uno da 500. I prezzi si muovono in percentuale.
Costruiamo allora un modello moltiplicativo. Prezzo iniziale 100 — una base qualunque, scelta perché rende ogni cifra leggibile come percentuale. A ogni periodo estraiamo un numero casuale \(U\) uniforme tra 0 e 1 — è solo il modo di simulare il lancio, non una probabilità nuova: la moneta resta equilibrata, \(p = 0{,}5\).
Se \(U > 0{,}5\) il prezzo sale dell’1%. Altrimenti scende dell’1%.
\[S_{t+1} = S_t \times 1{,}01 \qquad \text{oppure} \qquad S_{t+1} = S_t \times 0{,}99\]
Cento periodi dopo abbiamo una traiettoria irregolare che somiglia a un grafico finanziario. Rilanciamo la simulazione: ne esce un’altra, completamente diversa, prodotta dalle identiche regole.
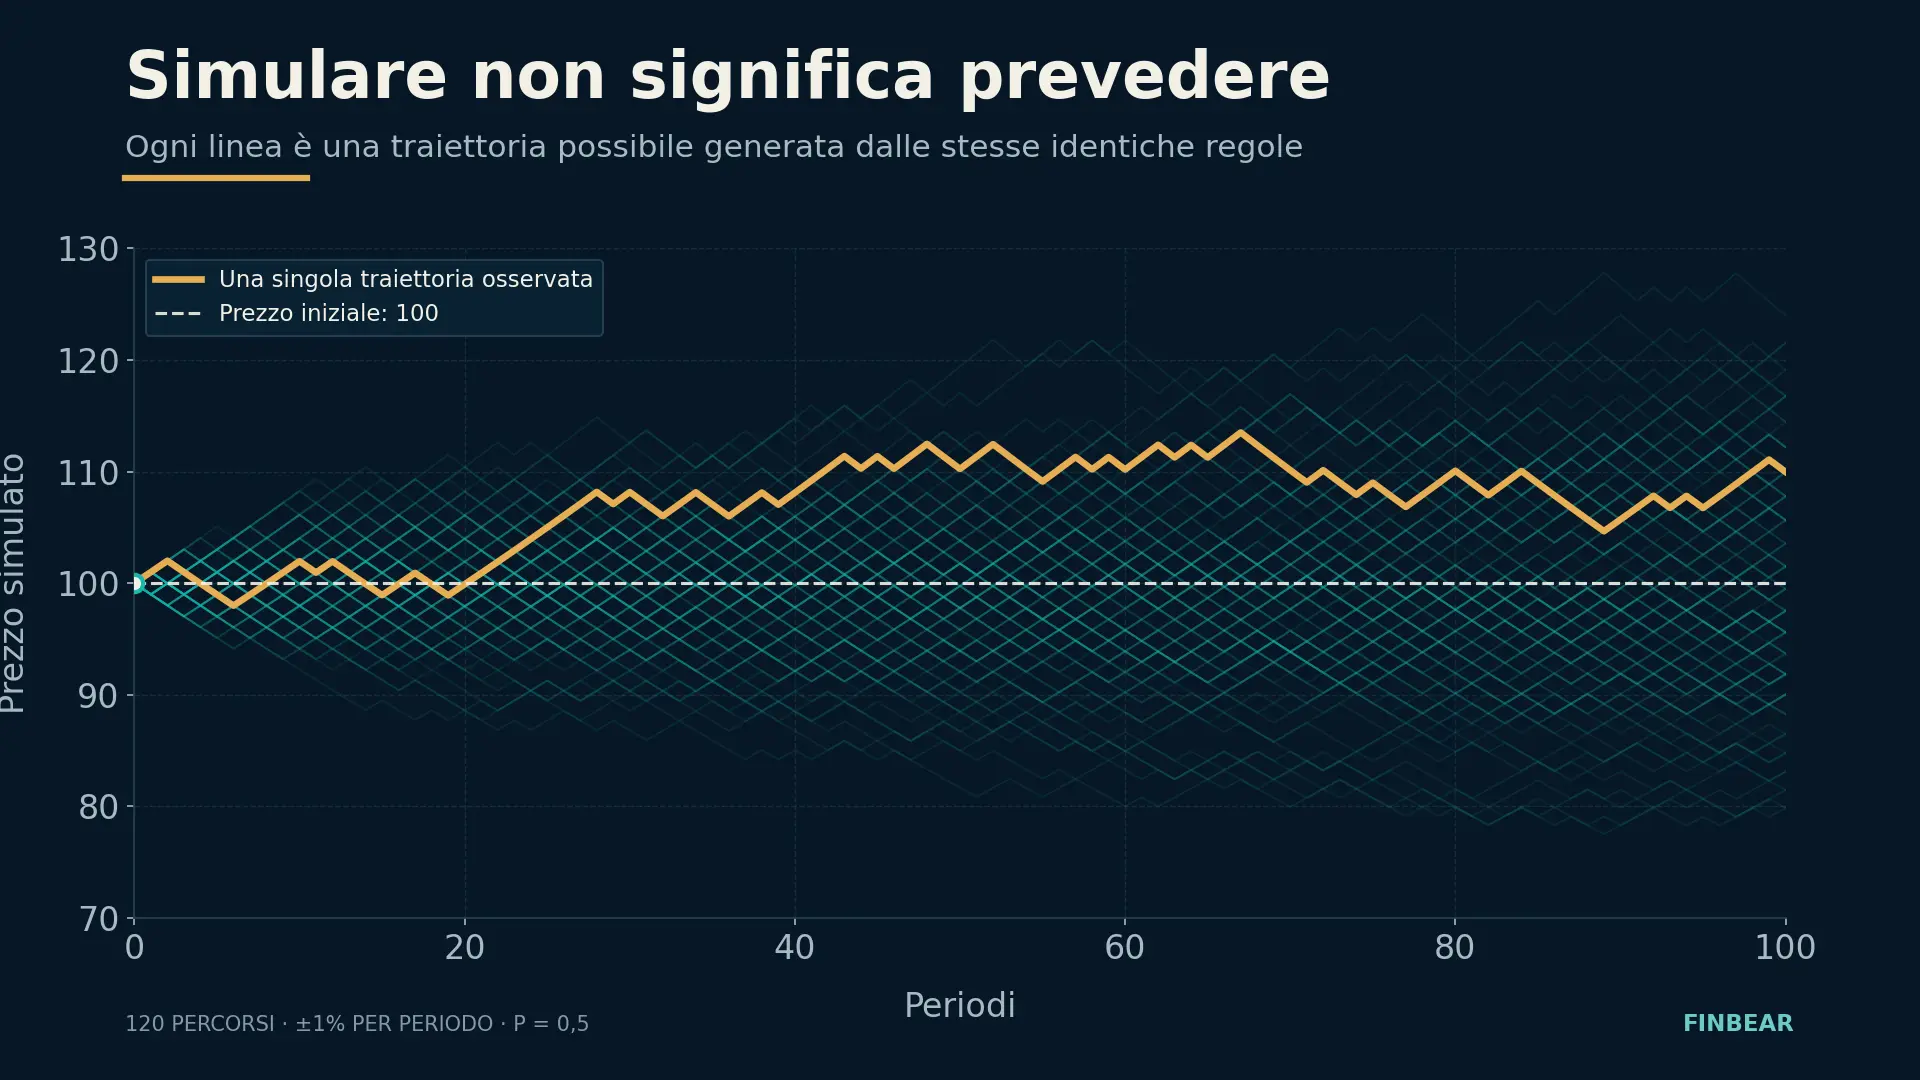
Il modello non ha previsto niente. Ha generato una delle traiettorie compatibili con le sue regole. Il grafico che vedi non è il futuro: è un campione da un’urna.
La trappola del più uno e meno uno per cento
Salire dell’1% e poi scendere dell’1% sembra un’operazione a somma zero.
Non lo è.
\[1{,}01 \times 0{,}99 = 0{,}9999\]
Cento euro salgono a 101,00 e scendono a 99,99. Mancano 0,01. Sembra polvere.
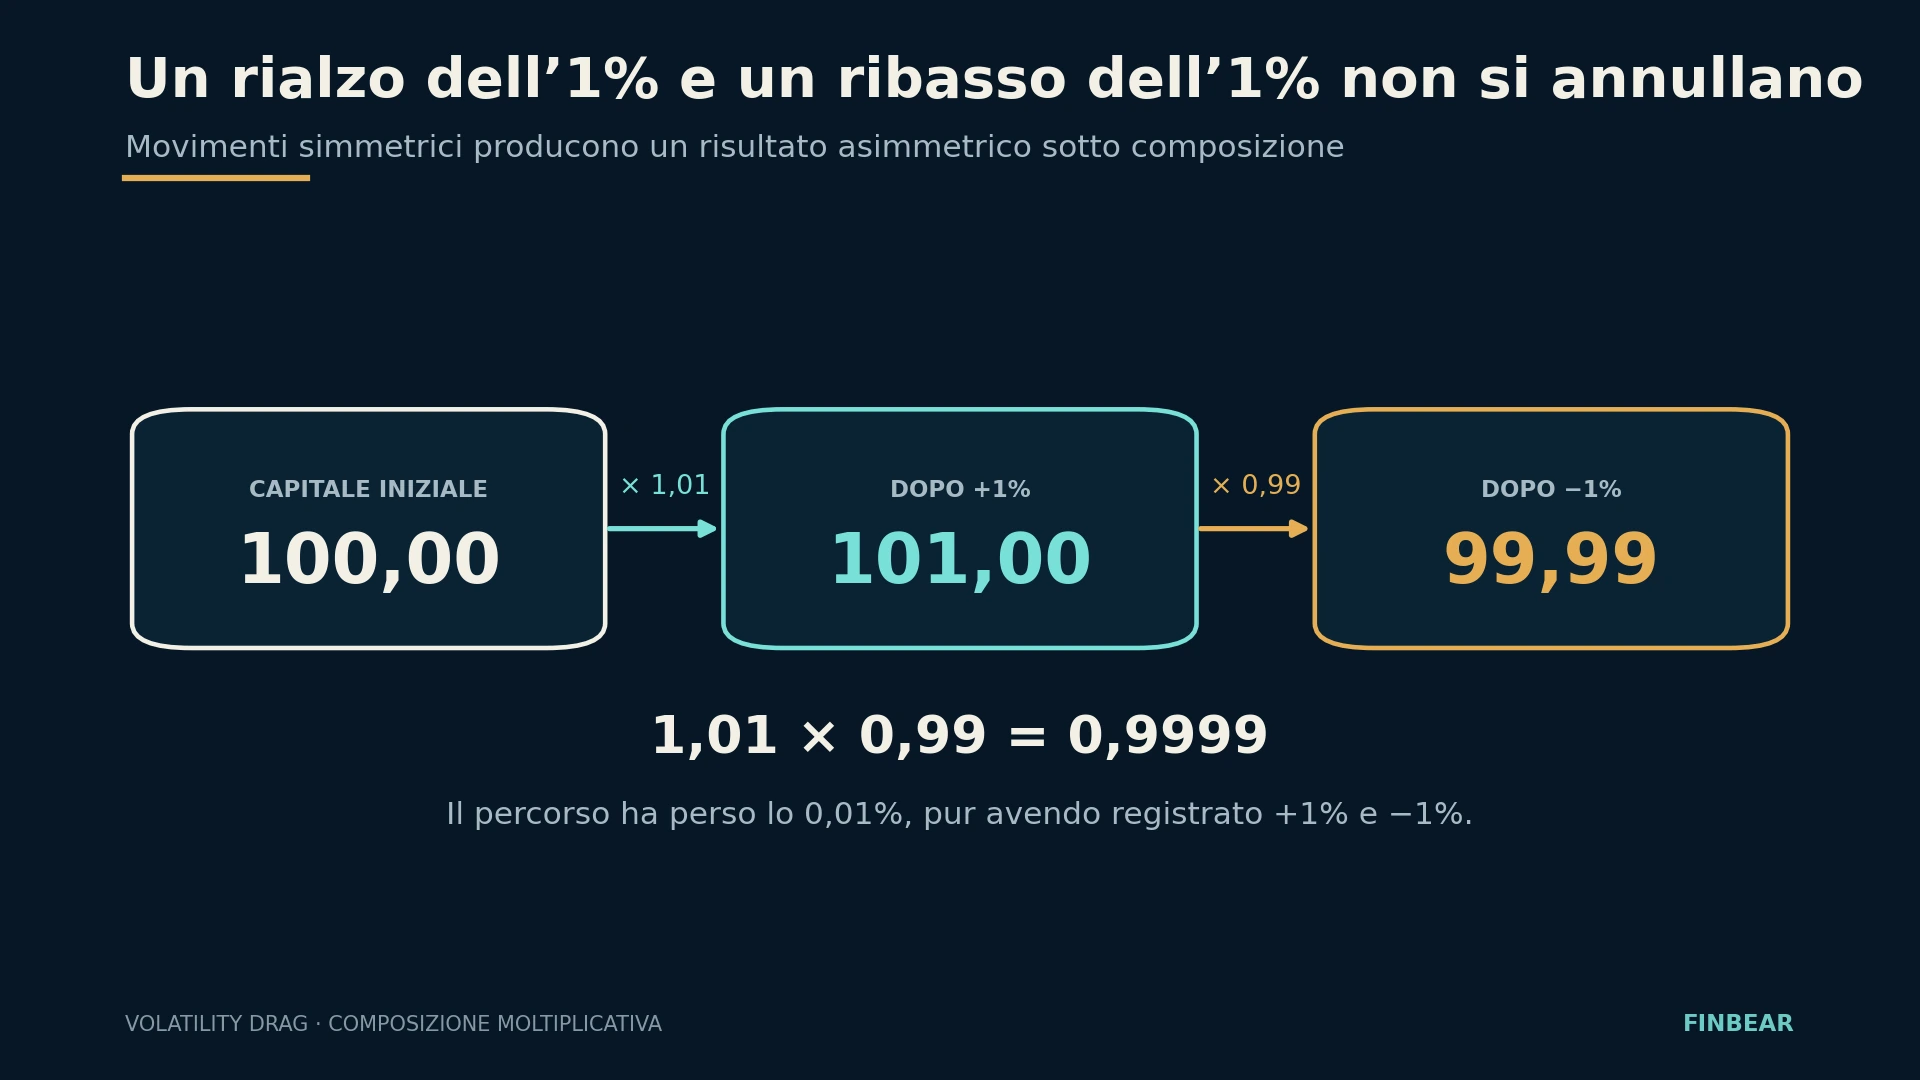
Non è polvere, perché si compone. Ed ecco il conto che nel modello di prima nessuno fa mai. Il valore atteso aritmetico del moltiplicatore vale esattamente 1:
\[0{,}5 \times 1{,}01 + 0{,}5 \times 0{,}99 = 1\]
Quindi il prezzo atteso dopo 100 periodi è ancora 100. Ma il valore terminale mediano — quello dei percorsi con 50 rialzi e 50 ribassi, che è l’esito terminale più probabile — vale:
\[100 \times (1{,}01 \times 0{,}99)^{50} = 99{,}50\]
Media 100. Mediana 99,50. Lo stesso identico processo, due numeri diversi.
E qui la domanda giusta è: perché dovrebbe contare il secondo?
Perché la distribuzione degli esiti non è simmetrica. Moltiplicando, le discese si comprimono verso il basso — per quanto tu perda, non puoi scendere sotto zero — mentre le salite si compongono senza tetto. Il risultato è una distribuzione sbilanciata a destra, con una coda lunga di percorsi molto fortunati e rari. Quella coda tira su la media senza spostare il centro.
Il conto lo si può fare esattamente. Su cento lanci, per chiudere sopra 100 servono almeno 51 rialzi; la probabilità di ottenerli è 46%. Il che significa che il 54% dei percorsi finisce sotto la media. Il valore atteso non è l’esito tipico: è un numero che la maggioranza dei giocatori non raggiunge, tenuto in piedi da una minoranza che ha fatto molto meglio.
E la forbice si allarga con il tempo. Su mille lanci invece di cento, la media resta 100 mentre la mediana scende a 95,12.
Da qui la ragione pratica. La media aritmetica è la risposta giusta a una domanda che nessuno ti sta facendo: quanto otterrebbe in media un insieme di mille giocatori paralleli? Quella domanda ha senso per chi diversifica su molte scommesse indipendenti nello stesso istante. Ma tu non sei mille giocatori: sei uno solo, che percorre una sequenza di lanci uno dopo l’altro, e non puoi diversificare su copie parallele di te stesso. Per chi vive un percorso nel tempo, la statistica pertinente è la crescita composta lungo quel percorso; nel nostro modello la mediana ne rappresenta l’esito tipico.
È la distinzione tra media d’insieme e media temporale — quello che Ole Peters ha rimesso al centro del dibattito con l’economia ergodica. Non è pedanteria accademica: è la differenza tra il numero che ti mostrano nella presentazione e il numero che trovi sull’estratto conto.
Questo è il volatility drag: la volatilità erode la crescita composta anche quando è perfettamente simmetrica. Non serve sbagliare direzione. Basta oscillare.
È anche il motivo per cui la matematica delle perdite non perdona. Da 100 perdi il 50% e sei a 50; guadagni il 50% e sei a 75. Per tornare a 100 ti serve il 100%. Il recupero non è mai proporzionale al danno, e la distanza cresce più che linearmente: da −20% servono +25%, da −50% servono +100%, da −80% servono +400%.
Proteggere il capitale dalle perdite grandi non è prudenza caratteriale. È aritmetica.
Dove finiscono i conti: μ − σ²/2
Se rendiamo i passi infinitamente piccoli e gli intervalli infinitamente brevi, la passeggiata casuale converge — con un opportuno riscalamento — a un processo continuo: il moto browniano. La versione usata in finanza è il moto browniano geometrico:
\[dS_t = \mu S_t\,dt + \sigma S_t\,dW_t\]
dove \(S_t\) è il prezzo, \(\sigma\) la volatilità, \(dW_t\) lo shock casuale. E \(\mu\) è la deriva attesa — ma attesa di che cosa, esattamente?
Risolvendo l’equazione si scopre che il prezzo atteso cresce come \(e^{\mu t}\), mentre il prezzo mediano cresce come:
\[e^{\left(\mu – \frac{\sigma^2}{2}\right)t}\]
Quel \(-\sigma^2/2\) non è un dettaglio tecnico. È il volatility drag di due paragrafi fa, scritto in forma continua.
Verifichiamolo sul nostro modello a monetina, perché il conto torna in modo quasi imbarazzante. Il rendimento semplice atteso per periodo è zero, quindi \(\mu = 0\). La sua deviazione standard è 0,01, quindi:
\[\frac{\sigma^2}{2} = \frac{0{,}0001}{2} = 5{,}0 \times 10^{-5}\]
E la crescita logaritmica attesa che avevamo calcolato a mano:
\[\frac{\ln(1{,}01) + \ln(0{,}99)}{2} = -5{,}00025 \times 10^{-5}\]
Stesso numero fino alla quarta cifra significativa. Il termine che rende 100 diverso da 99,50 nel giocattolo a monetina è lo stesso termine che compare nella formula su cui è costruito mezzo mercato dei derivati.
Vale la pena sapere da dove viene tutto questo, perché non è caduto dal cielo. Louis Bachelier lo intuì nel 1900, nella tesi Théorie de la spéculation discussa con Poincaré: applicò il moto browniano ai prezzi cinque anni prima che Einstein lo usasse per le particelle, e fu ampiamente ignorato per mezzo secolo. Osborne lo riprese nel 1959 osservando che a distribuirsi normalmente non sono i prezzi ma le loro variazioni logaritmiche. Samuelson lo portò nella formulazione economica moderna come processo moltiplicativo, cioè il moto browniano geometrico. Da lì, nel 1973, Black, Scholes e Merton.
Un modello non è la realtà. È una realtà semplificata al punto da poter essere interrogata.
Simulare non significa prevedere
Torniamo al punto scomodo. Un processo interamente casuale produce grafici che sembrano mercati: trend, ritracciamenti, supporti che tengono, figure che si ripetono. Puoi tracciarci sopra le tue linee e funzionano, perché le hai tracciate dopo.
Questo non dimostra che i prezzi siano puro rumore, e non dimostra che l’analisi sia inutile. Dimostra qualcosa di più fastidioso:
Una traiettoria dall’aspetto perfettamente sensato può essere prodotta anche dal caso.
Il cervello umano è una macchina per trovare figure, e non ha un interruttore per spegnersi quando le figure non ci sono. Vede volti nelle nuvole e testa-e-spalle nel rumore bianco con lo stesso entusiasmo.
Ed è per questo che una strategia non si giudica su un grafico ben scelto. Si giudica chiedendo:
- su quante osservazioni poggia;
- quante varianti sono state provate prima di fermarsi su quella;
- che cosa avrebbe prodotto il caso puro sullo stesso campione;
- se il vantaggio sopravvive ai costi di transazione;
- se dipende da tre eventi eccezionali su duecento;
- se tiene fuori dal periodo su cui è stata costruita;
- se regge in un regime di mercato diverso da quello in cui è nata.
Sette domande. Nessuna richiede matematica avanzata, tutte richiedono onestà. La ragione per cui quasi nessuno se le pone è che quattro volte su cinque la risposta uccide l’idea.
La seconda, in particolare, è quella che nessuno pone mai — e merita un articolo per conto suo.
Dove il modello si rompe — e perché è la parte migliore
Un pezzo che finisse qui sarebbe un pezzo disonesto. Perché il moto browniano geometrico, per quanto elegante, descrive male i mercati veri. E i modi in cui li descrive male sono la cosa più interessante di tutta la storia.
I rendimenti reali hanno code più spesse di quanto la distribuzione normale ammetta, e non di poco. Il conto sull’indice $SPX dal 1950 a oggi è impietoso: su 19.257 rendimenti logaritmici giornalieri, la distribuzione normale ne prevede 0,011 oltre cinque deviazioni standard — in pratica nessuna, mai, in settantasei anni. Se ne contano 53. Il modello sbaglia di un fattore quattromilaottocento.
E il 19 ottobre 1987 non è una seduta a cinque sigma: è a ventitré. Un evento che la curva normale colloca oltre qualunque scala temporale immaginabile, e che è semplicemente successo un lunedì. Il che rende l’espressione «evento a sei sigma», ogni volta che la senti pronunciare da un gestore, più una confessione che una misura.
I mercati hanno poi salti che nessun processo continuo può generare, volatilità a grappoli — giorni agitati che chiamano altri giorni agitati, calma che chiama calma — mentre nel modello ogni passo è indipendente dal precedente. E correlazioni che si spostano proprio quando servirebbero stabili, convergendo a uno esattamente nel momento in cui contavi sulla diversificazione.
Benoît Mandelbrot lo scrisse già nel 1963 studiando i prezzi del cotone, e per quarant’anni la professione preferì un modello sbagliato ma trattabile a uno giusto ma scomodo.
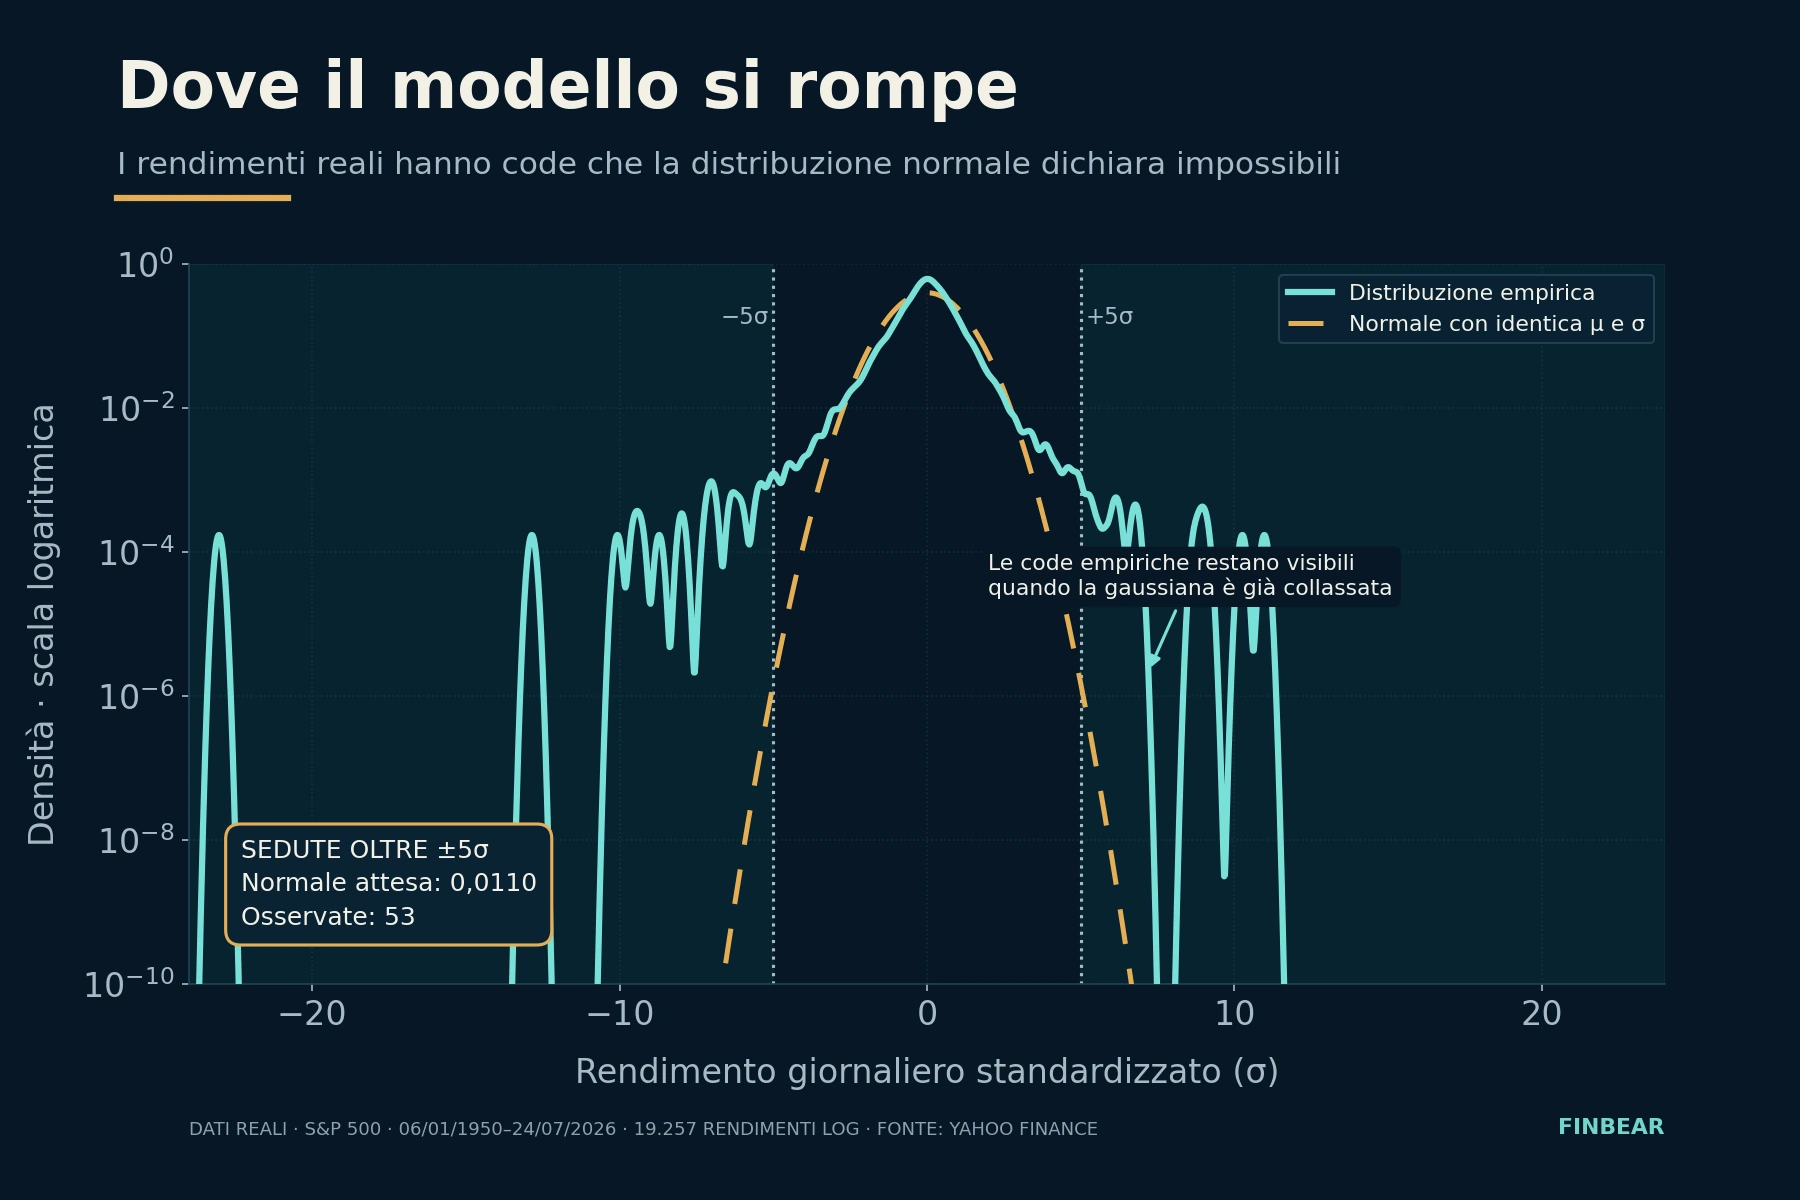
Da quelle rotture è nato tutto il resto: i modelli a volatilità stocastica, i processi a salti, le famiglie GARCH, la misura del rischio di coda. La finanza quantitativa seria non è la difesa del moto browniano. È il catalogo dei modi in cui si rompe.
Che cosa ne fa FINBEAR
Se il mercato fosse solo una moneta equilibrata, nessuna analisi produrrebbe un vantaggio persistente e questo sito non avrebbe ragione di esistere. Il nostro mestiere non è dichiarare che il prossimo lancio sarà Testa. È cercare le situazioni in cui la moneta potrebbe non essere equilibrata — e misurare quanto poco lo è.
Con una differenza che separa una moneta da un mercato, ed è decisiva. La probabilità di Testa non cambia perché qualcuno ha scoperto che vale 0,5. Un’anomalia di mercato, invece, quando viene trovata e sfruttata da abbastanza operatori, si riduce, muta o sparisce. L’edge non è una proprietà: è una condizione con una data di scadenza che nessuno ti comunica in anticipo. Va misurato, verificato e rimesso alla prova.
Nel metodo FINBEAR questo si traduce in tre strumenti che fanno tre lavori diversi.
La Pythia dei Mercati disegna il cono: non dove andrà il prezzo, ma la forma dell’insieme dei percorsi possibili e quanto è largo. È il grafico della dispersione di questo articolo, applicato agli asset veri. Serve a togliere dalla testa la traiettoria unica.
Quant cerca dove la moneta è storta. Filtra un universo ampio per anomalie statistiche, fattori persistenti, asimmetrie tra rischio e rendimento, comportamenti ricorrenti — comprese le società che nessuno guarda.
Istruttoria interroga il candidato. Perché un segnale quantitativo non chiude l’analisi: la apre. Da dove viene quel vantaggio, è sostenibile, che rischi nasconde il bilancio, esiste un catalizzatore verificabile, oppure quel numero è solo il rumore che ci aspettavamo di trovare cercando in abbastanza posti.
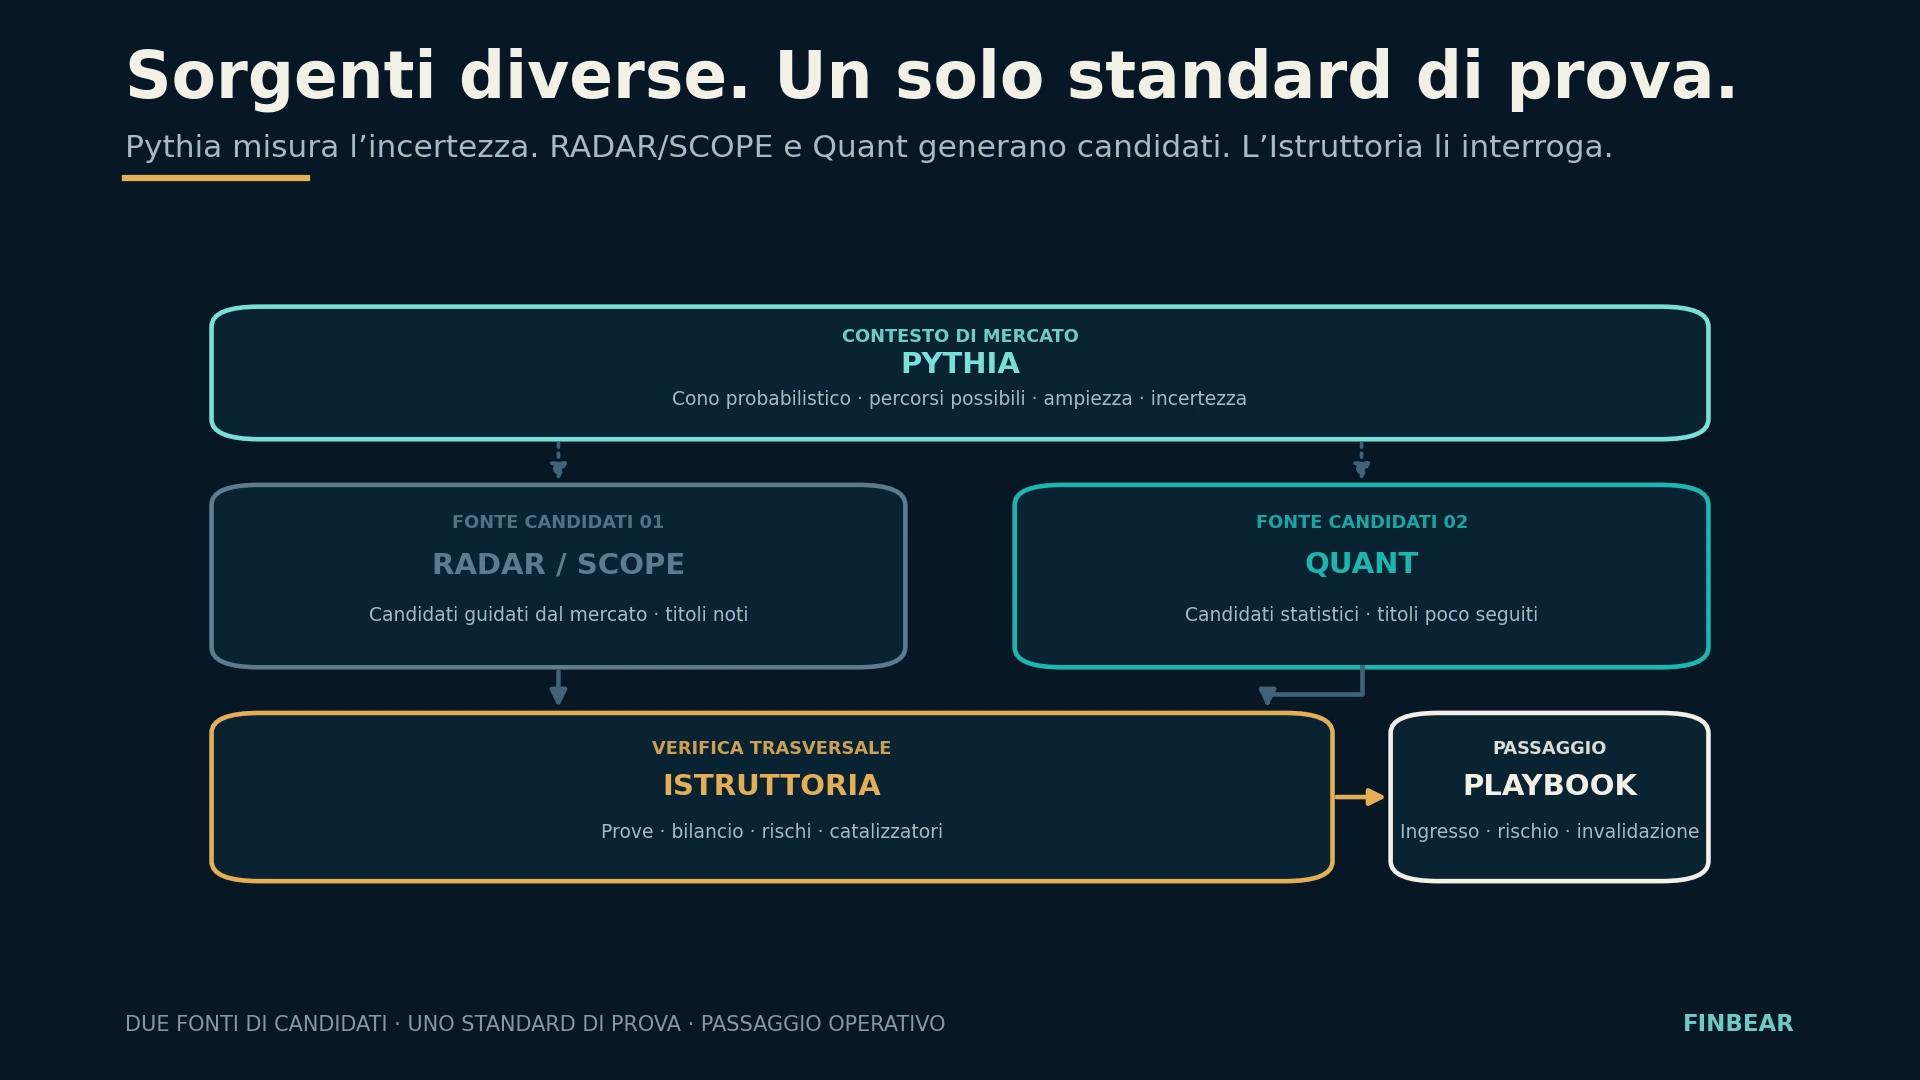
Pythia misura l’incertezza. Quant seleziona il caso. Istruttoria esamina le prove. E la sentenza, come sempre, la scrive il prezzo.
Non indovinare. Misurare.
La matematica del lancio di una moneta non consegna nessuna formula per prevedere il mercato. Consegna qualcosa di più utile e molto meno vendibile.
Che il valore atteso non è il risultato che vedrai. Che l’incertezza cresce anche quando la media resta immobile, e cresce come radice del tempo. Che uno scarto minuscolo dal 50% può cambiare tutto, ma solo se sopravvivi abbastanza a lungo da vederlo agire. Che la volatilità erode la crescita composta anche quando è perfettamente simmetrica. E che un grafico convincente può nascere dal nulla.
Il mestiere comincia quando smetti di chiedere che cosa succederà e inizi a chiedere quali esiti sono possibili, con quale probabilità, quanto puoi guadagnare, quanto puoi perdere, quale vantaggio credi di avere e quali prove escludono che sia fortuna.
Non stiamo cercando una moneta che dia sempre Testa. Non esiste, e chi te la vende sta vendendo l’unica cosa che nessuno possiede.
Stiamo cercando i tavoli dove probabilità, rendimento e rischio sono abbastanza sbilanciati da giustificare una decisione — e un modo di giocare che ci tenga seduti abbastanza a lungo perché lo scarto abbia il tempo di manifestarsi.
Prima capire. Poi operare.
Fonti
I lavori originali che compongono la genealogia richiamata nell’articolo. Sono tutti consultabili: dove la versione integrale è disponibile in accesso libero, è indicata la sede.
Louis Bachelier, Théorie de la spéculation, Annales scientifiques de l’École Normale Supérieure, 1900 — la tesi che applica il moto browniano ai prezzi cinque anni prima di Einstein. Disponibile su Numdam, insieme al rapporto di valutazione redatto da Poincaré.
M. F. M. Osborne, Brownian Motion in the Stock Market, Operations Research, vol. 7 n. 2, 1959 — dimostra che a distribuirsi normalmente non sono i prezzi ma le loro variazioni logaritmiche.
Paul A. Samuelson, Rational Theory of Warrant Pricing, Industrial Management Review, 1965 — porta il processo moltiplicativo nella formulazione economica moderna.
Benoît Mandelbrot, The Variation of Certain Speculative Prices, The Journal of Business, 1963 — lo studio sui prezzi del cotone che documenta le code grasse quarant’anni prima che la professione le prendesse sul serio.
J. L. Kelly Jr., A New Interpretation of Information Rate, Bell System Technical Journal, 1956 — il criterio di dimensionamento nato studiando il rumore sui canali di trasmissione.
Fischer Black e Myron Scholes, The Pricing of Options and Corporate Liabilities, Journal of Political Economy, 1973, e Robert C. Merton, Theory of Rational Option Pricing, Bell Journal of Economics and Management Science, 1973 — due lavori distinti dello stesso anno.
Ole Peters, The ergodicity problem in economics, Nature Physics, 2019, e Ole Peters e Murray Gell-Mann, Evaluating gambles using dynamics, Chaos, 2016 — la distinzione tra media d’insieme e media temporale.
Dati della tavola sulle code: serie storica giornaliera dell’indice $SPX dal 6 gennaio 1950 al 24 luglio 2026, 19.257 rendimenti logaritmici. Conteggi ricalcolati in modo indipendente.
📜 Disclaimer & Massima Fantiborsa™
🛡️ Disclaimer FINBEAR™:
Questo articolo è materiale didattico. Non è un consiglio d’investimento, non è una sollecitazione al pubblico risparmio e non è una previsione — parola che in questo pezzo abbiamo passato duemila battute a smontare, quindi sarebbe scortese reintrodurla nelle note legali. Se dopo aver letto che il valore atteso non è il risultato che vedrai decidi comunque di mettere l’ottanta per cento del patrimonio su una singola idea, il problema non è la matematica: la matematica ti ha avvertito. Nessun contenuto FINBEAR ti dirà mai come cadrà la prossima moneta. Ti insegniamo a stimare quanto è storta, quanto ti costa sbagliare e quanto devi mettere sul tavolo per essere ancora seduto al lancio numero cento. Il resto lo firmi tu. La sentenza la scrive il prezzo.
🎭 Massima Fantiborsa™:
«Non serve sapere come cade la moneta. Serve sapere se puoi permetterti di lanciarla ancora.»
© FINBEAR™ | Fantiborsa™ | Powered by Pythia™ — Tutti i diritti riservati